
一、产业园区开展Token算力补贴核心痛点
(一)计量与财政审计风险(政府首要关切)
- Token属于虚拟服务消耗,无实物载体,传统财务体系难以核验业务真实性,存在虚增调用、空转刷单、中间商套取财政补贴的风险。
- 各上游大模型厂商Token计费口径不统一,计量单位、统计规则存在差异,园区缺少统一计量标尺,难以横向核验企业真实消耗规模。
- 无法有效区分渠道中间商备货消耗与终端企业真实业务消耗,中间商采购额度容易混入补贴核算池,造成财政资金流向中间环节,审计风险突出。
- 调用日志分散在各个大模型上游厂商,园区无法获取完整全链路审计证据,对账取证工作量大,人工核验成本高。
(二)算力供给生态痛点,企业获得感不足
- 多数园区算力补贴绑定单一算力服务商,企业原有技术栈需要迁移改造,迁移成本抵消补贴政策红利。
- 可选用模型种类有限,通用大模型、国产基座、行业垂类模型供给不足,无法满足企业多样化研发需求。
- 大量中小科创企业、OPC创业团队缺少技术研发人力,对接多家大模型API调试成本高,使用门槛高。
(三)补贴流程与费用管控痛点
- 若采用直接抵扣模式,财政资金风险较高;采用事后补贴模式,园区缺少配套技术系统,消费流水、票据、调用日志归集全部依靠人工,申报流程繁琐、周期长。
- 缺少用量管控手段,企业算力消耗容易爆发式增长,出现补贴预算超支、单企业额度失控问题。
- 政策绩效难以评估,补贴额度大量闲置,无法量化政策对本地AI产业的实际带动效果。
(四)园区运营管理痛点
- 缺少一体化管理工作台,企业准入、资格审核、消耗统计、补贴数据归集、报表导出分散,运营效率低下。
- 缺少产业数据视图,无法统计辖区企业AI研发算力投入、模型使用结构,缺少数据支撑产业研判、招商引资工作。
- 合规压力突出:多模型聚合涉及生成合成类AI服务,算法备案、日志留存、内容安全过滤等合规工作,园区自身技术团队难以承接。
(五)商业渠道生态矛盾
园区希望引入总经销、代理商扩大算力服务推广覆盖面,但缺少技术手段隔离中间商备货消耗与终端企业真实业务消耗,容易引发财政审计质疑。
二、拍即得(paijide)针对性服务能力
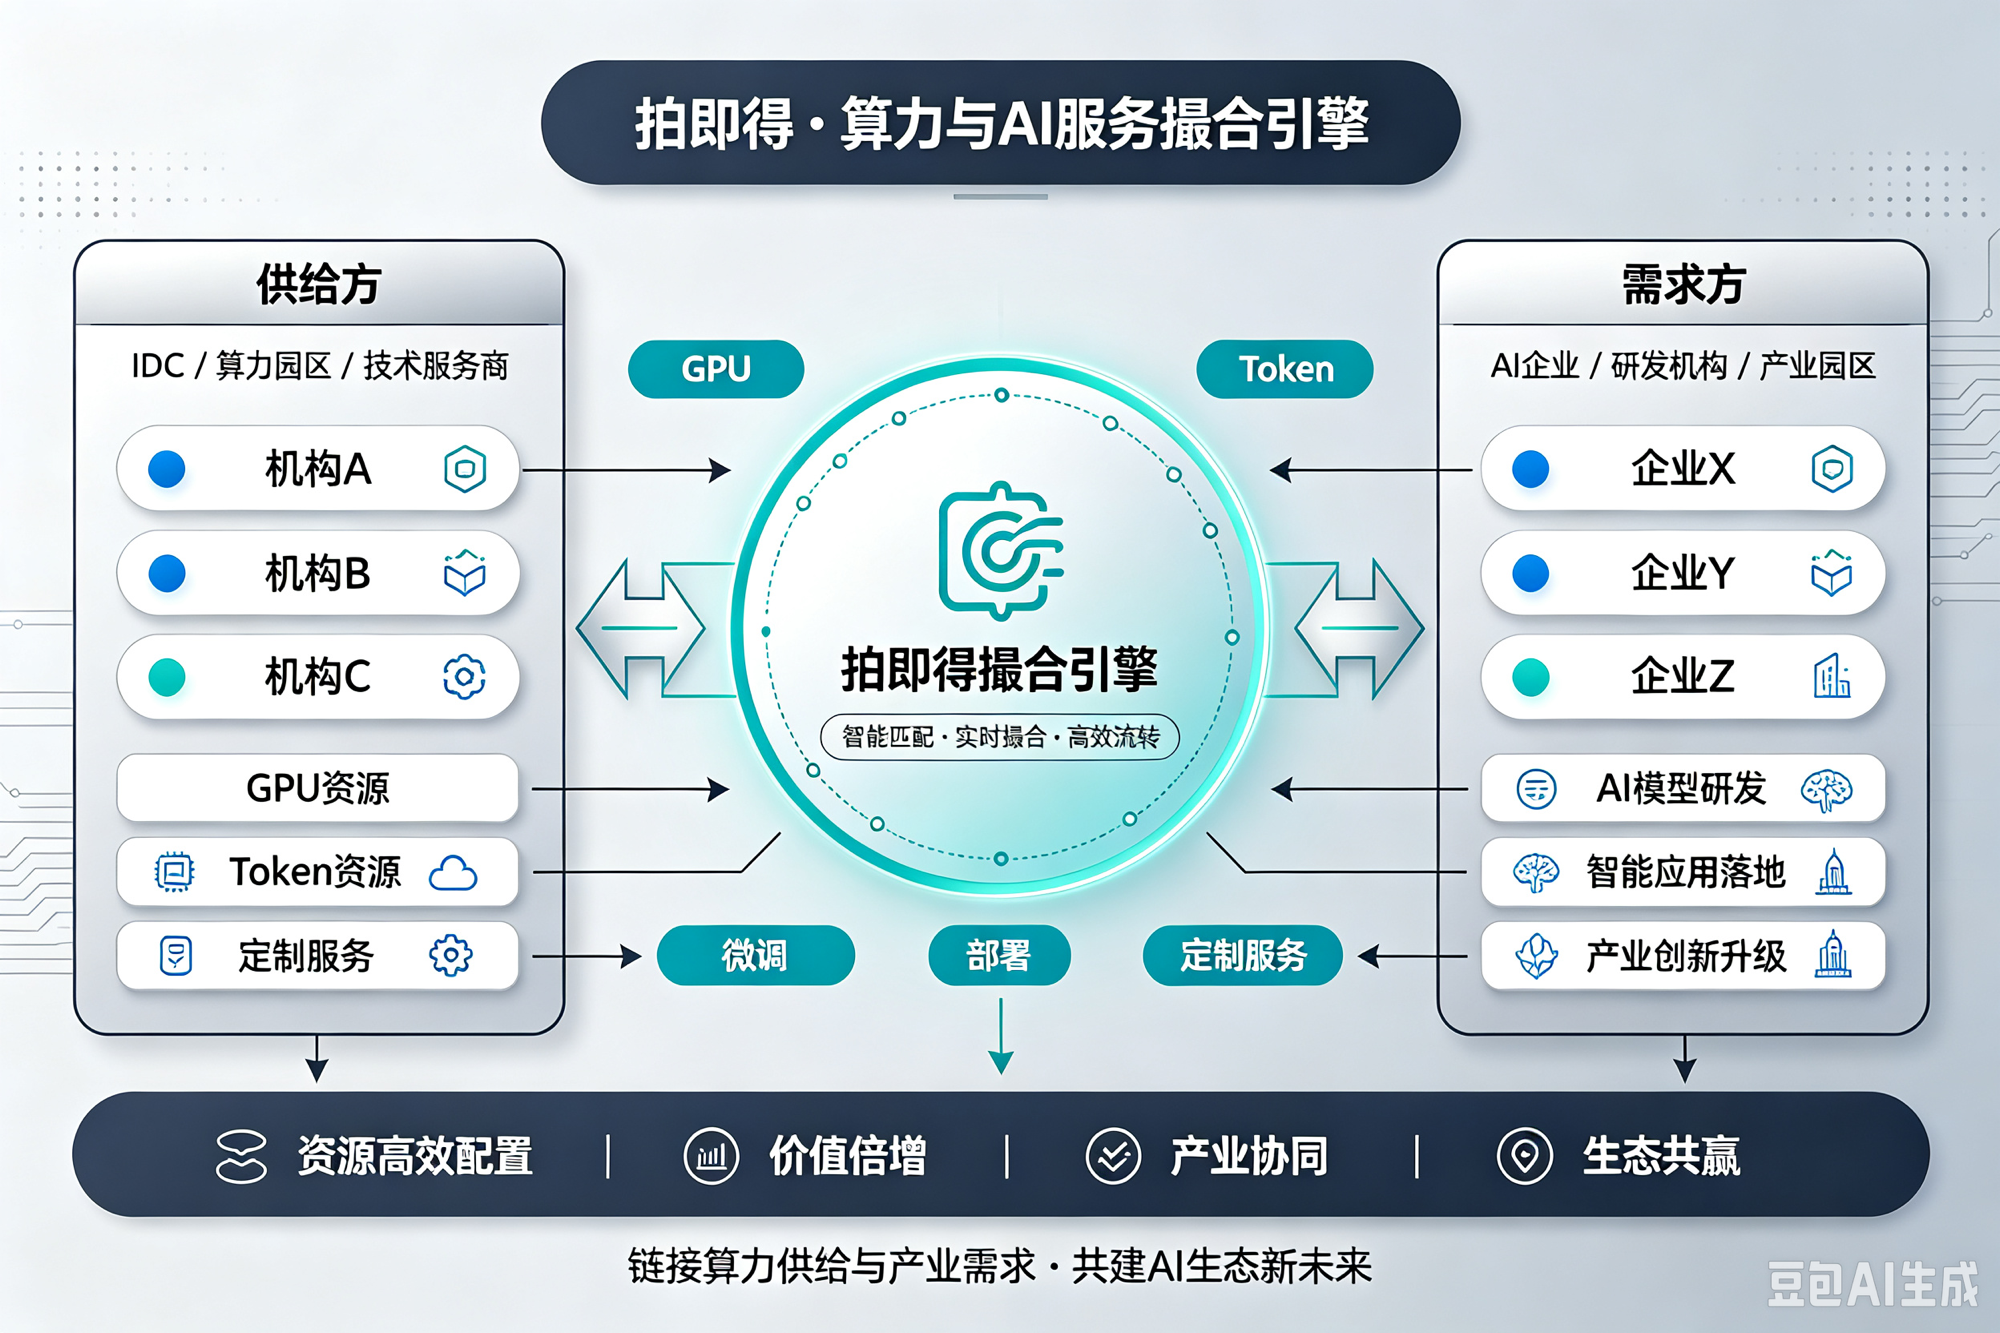
定位:园区算力补贴第三方技术支撑底座,不替代园区政策决策,提供算力聚合、统一计量、财政级审计、补贴业务全流程技术支撑,落地“先使用、后补贴”事后补助模式。
- 统一Token计量与财政级审计服务,筑牢资金安全防线
- 网关层完成多上游厂商Token口径归一换算,建立统一计量标准,解决不同模型计费规则不一致问题。
- 系统业务标签隔离机制,自动区分「渠道备货消耗」「终端企业真实业务消耗」,渠道备货消耗自动排除在补贴核算池之外,从技术层面规避中间商套取补贴。
- 留存全链路可审计调用日志:包含调用主体、时间戳、模型类型、入参出参摘要、Token消耗量,可导出标准化审计套件,可直接作为财政补贴审核取证材料。
- 内置风险识别告警,针对异常暴涨调用、空转刷量行为实时预警,协助园区拦截虚假算力消耗。
- 多模型聚合能力,降低企业使用门槛,提升政策获得感
- 聚合通用大模型、国产开源模型、行业垂类模型(如知识产权专业模型),一套API网关对接全部模型资源,企业无需改造迁移现有技术栈即可享受园区补贴政策。
- 兼容园区企业总经销、代理商商业合作模式,提供独立子商户后台,支持渠道商赚取Token批零差价;系统强制隔离渠道备货消耗,兼顾商业生态与财政合规要求。
- “先使用、后补贴”事后补助模式全套技术支撑
- 完整承接企业充值、真实消费全流程;预充值但未实际消耗的额度不计入补贴核算基数,仅统计已经发生真实业务的算力消耗。
- 自动归集符合政策条件企业的消费流水、调用凭证,输出标准化补贴申报数据包,大幅减少园区人工整理材料工作量。
- 预算管控能力:支持配置单企业补贴上限、园区整体补贴预算阈值,额度触达自动预警,防范财政预算超支。
- 支持企业黑白名单管理,可动态同步企业资质变更信息。
- 园区专属运营可视化工作台
- 园区管理看板:展示辖区企业算力消耗规模、模型使用结构、补贴候选池数据、补贴核销进度,实现政策效果可视化。
- 导出产业分析报表,为园区AI产业研判、招商引资提供数据依据。
- 账单、票据、消费凭证一键导出,方便企业完成补贴申报材料准备。
- 全套合规底座,减轻园区合规压力
- 聚合网关内置统一内容安全过滤能力,完整日志留存,落实深度合成相关管理要求。
- 平台完成对应算法相关合规备案工作,输出合规证明材料,降低园区合规责任。
- 提供标准化协议模板,区分终端企业服务协议、渠道代理商合作协议,清晰划分算法备案、内容安全各方权责。
- 两种部署模式灵活适配园区需求
- SaaS模式:园区直接对接api.paijide.com,轻量化落地,无需自建软硬件平台;
- 私有化部署:可将聚合网关、补贴审计模块部署到园区指定基础设施环境。